Limiar · Class 6

MNIST: treino, validação e teste

  • WhenSexta, 27/11/2026, das 12h às 14h
  • WhereOn-line, no encontro 2
  • Taught byChrysthofer A. A. Afonso

In the slides: → moves on, F is full screen, N shows the notes, H lists every key. The PDF has no notes: it is the one handed to the class.

The class

Topic

O MNIST, um conjunto de 70 mil dígitos escritos à mão. Um MLP com 784 entradas, uma camada oculta com a tanh e 10 saídas com a softmax, treinado com a entropia cruzada em lotes. Separar os dados em três partes: treino, para ajustar os pesos; validação, para escolher o tamanho da rede e a hora de parar; teste, para medir uma única vez no fim. O sobreajuste, quando a rede decora o treino e erra no dado novo. A acurácia, a fração de acertos. Na história, de onde vêm os dígitos do MNIST, escritos por funcionários do censo dos Estados Unidos e por estudantes do ensino médio, e a rede LeNet-5, de LeCun e colegas, de 1998.

Practice in class

Um MLP no MNIST em NumPy, escrito a partir de um esqueleto, com os dados já carregados.

Assignment

  • O esqueleto com as três funções escritas, softmax, para_a_frente e retropropagacao; a acurácia no teste, com a semente e a versão dos dados registradas, e as curvas de erro de treino e de validação.
  • Uma pergunta sobre o estudo da semana.
Study for the week

PyTorch, tutorial "Learn the Basics": docs.pytorch.org/tutorials/beginner/basics/intro.html.

2022The spelled-out intro to neural networks and backpropagation: building microgradAndrej Karpathy · Watch on YouTube

Diederik Kingma e Jimmy Ba, 2014, "Adam: A method for stochastic optimization", arXiv:1412.6980, apresentado na conferência ICLR de 2015. Só o quadro do algoritmo, o Algorithm 1.

Papers and books

Every work cited in the class material, with the official link. The first page appears where the PDF is open access.

  1. Gradient-based learning applied to document recognition

    Yann LeCun, Léon Bottou, Yoshua Bengio e Patrick Haffner · 1998

    Proceedings of the IEEE 86(11):2278-2324

    O PDF é a versão dos autores, no site de LeCun; a seção III-A conta de onde vêm os dígitos do MNIST.

  2. Deep Learning

    Ian Goodfellow, Yoshua Bengio e Aaron Courville · 2016

    MIT Press; o capítulo 6, citado no roteiro, está no site do livro

  3. Adam: A method for stochastic optimization

    Diederik P. Kingma e Jimmy Ba · 2014

    arXiv:1412.6980; apresentado na conferência ICLR de 2015

Other sources 10

Image credits

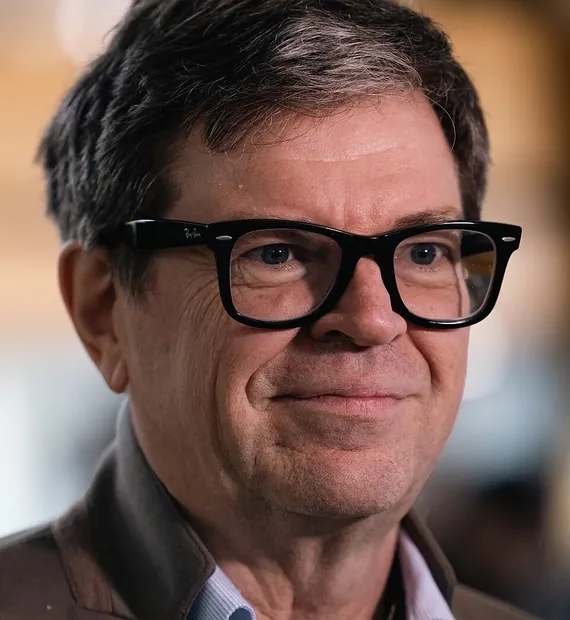
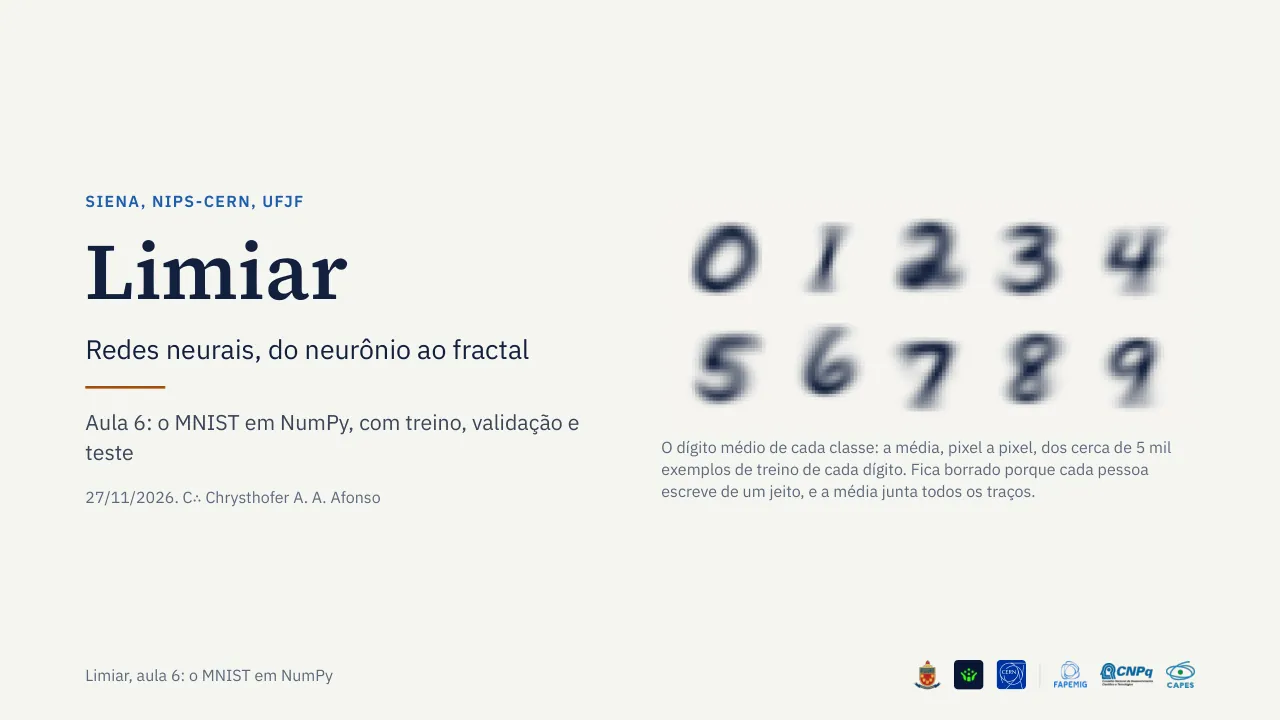
O retrato, no slide da história, é do Wikimedia Commons; as outras imagens saem do código desta pasta, com os dígitos do MNIST, e a da capa, o dígito médio de cada classe, de codigo/figuras_slides.py.

Arquivo O que mostra Autor Licença
lecun.jpg Yann LeCun na conferência "AI, Science and Society", na École polytechnique, 11/02/2025; "Yann LeCun - 2025 (cropped).jpg", na largura de 960 pixels École polytechnique CC BY-SA 2.0