Limiar · Class 2

Derivada, gradiente e gradiente descendente

  • WhenSexta, 02/10/2026, das 12h às 14h
  • WhereSegundo andar do PPEE
  • Taught byChrysthofer A. A. Afonso

In the slides: → moves on, F is full screen, N shows the notes, H lists every key. The PDF has no notes: it is the one handed to the class.

The class

Topic

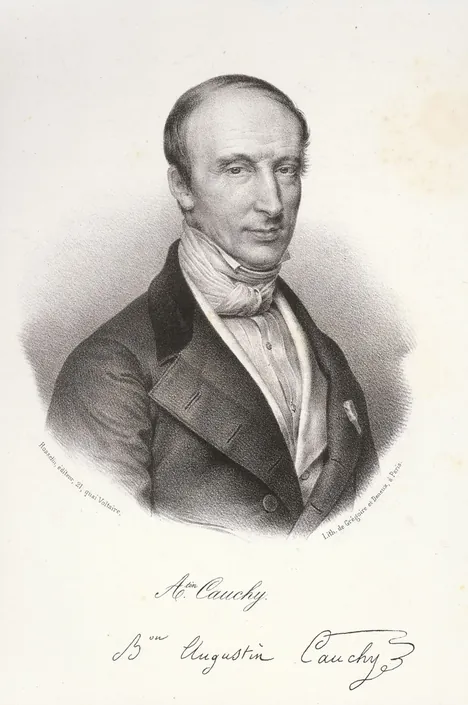
A derivada como taxa de variação: quanto a saída muda quando a entrada muda um pouco. A derivada parcial, a derivada em relação a uma variável com as outras paradas. O gradiente, o vetor das derivadas parciais, que aponta para onde a função mais cresce. O gradiente descendente, que anda contra o gradiente para diminuir o erro, visto numa superfície em 3D. O erro quadrático médio, a média dos quadrados das diferenças entre o previsto e o certo. A taxa de aprendizado, o tamanho de cada passo. Na história, Cauchy, 1847, que criou o método para calcular órbitas, e Widrow e Hoff, 1960: a Adaline, um neurônio linear treinado assim, é o começo dos filtros adaptativos. Filtro adaptativo fica como caixa-preta: entra só a história.

Practice in class

Ajustar uma reta a um conjunto de pontos por gradiente descendente, em NumPy, e variar a taxa de aprendizado. Pequena demais, o erro quase não cai; grande demais, o erro explode. É o primeiro contato com o limiar do projeto final.

AssignmentDue

  • O gráfico do erro a cada passo, para várias taxas, e a taxa a partir da qual o treino diverge.
  • Uma pergunta sobre o estudo da semana.
Papers and books

Every work cited in the class material, with the official link. The first page appears where the PDF is open access.

  1. Méthode générale pour la résolution des systèmes d'équations simultanées

    Augustin-Louis Cauchy · 1847

    Comptes rendus hebdomadaires des séances de l'Académie des sciences 25:536-538, sessão de 18/10/1847

    Domínio público. A capa é a página 536, a primeira da nota.

  2. Adaptive switching circuits

    Bernard Widrow e Marcian E. Hoff · 1960

    IRE WESCON Convention Record, parte 4, 96-104

    O Record da WESCON não tem página de editora nem DOI; o PDF é o que Widrow mantém em Stanford.

  3. ADALINE: Smarter than Sweet

    Bernard Widrow · 1963

    Stanford Today, série 1, número 6, setembro de 1963

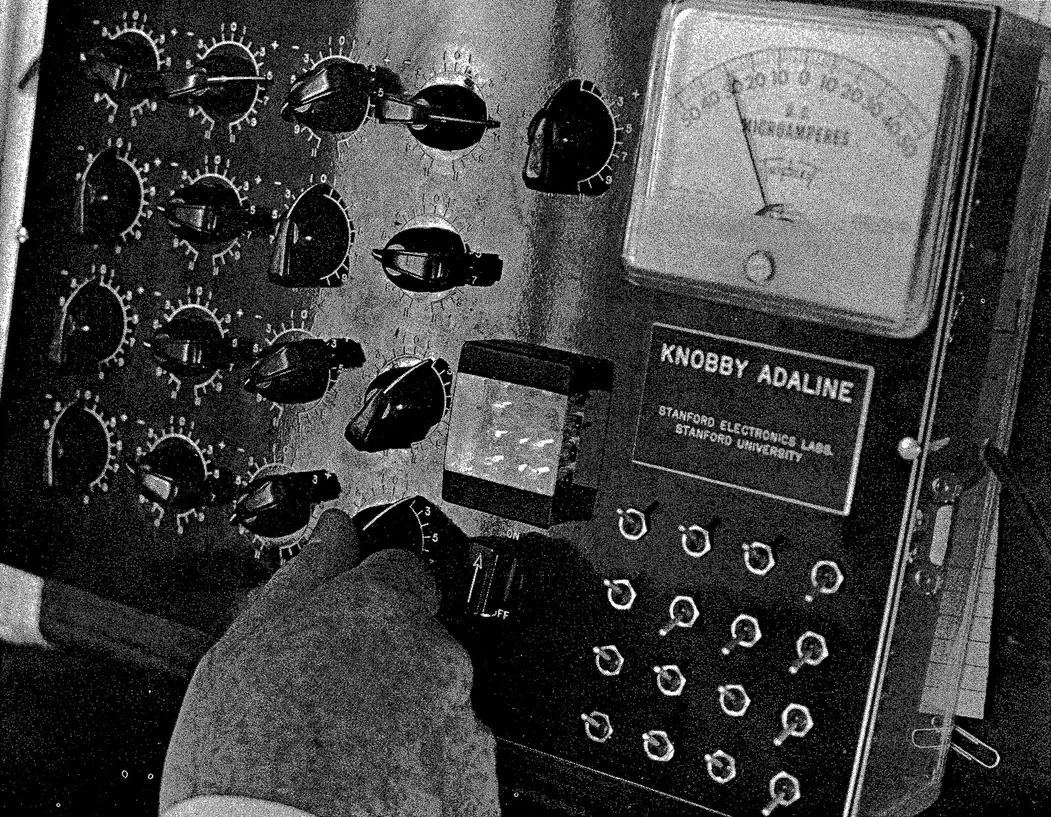
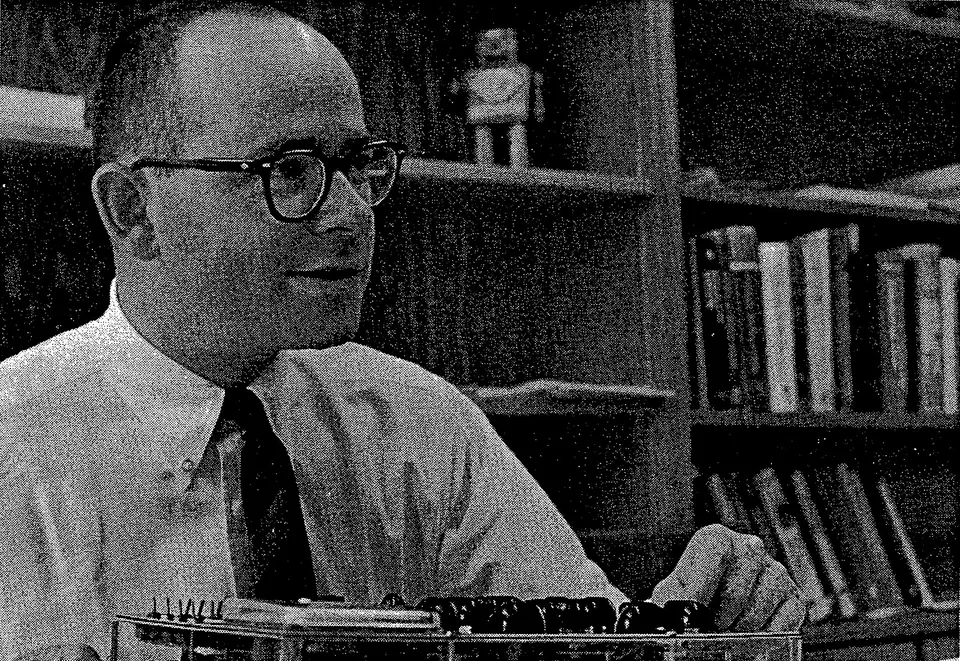
    De onde vêm as duas fotos da Adaline dos slides.

  4. Cauchy and the gradient method

    Claude Lemaréchal · 2012

    Documenta Mathematica, volume extra ISMP, 251-254

  5. Neural Networks and Deep Learning

    Michael A. Nielsen · 2015

    Determination Press, livro online; CC BY-NC 3.0

    O endereço só abre em http: o certificado do servidor é de outro domínio.

  6. The boundary of neural network trainability is fractal

    Jascha Sohl-Dickstein · 2024

    arXiv:2402.06184; CC BY 4.0

Other sources 7

Image credits

As três fotos são do Wikimedia Commons; as outras imagens saem do código desta pasta.

Arquivo O que mostra Autor Licença
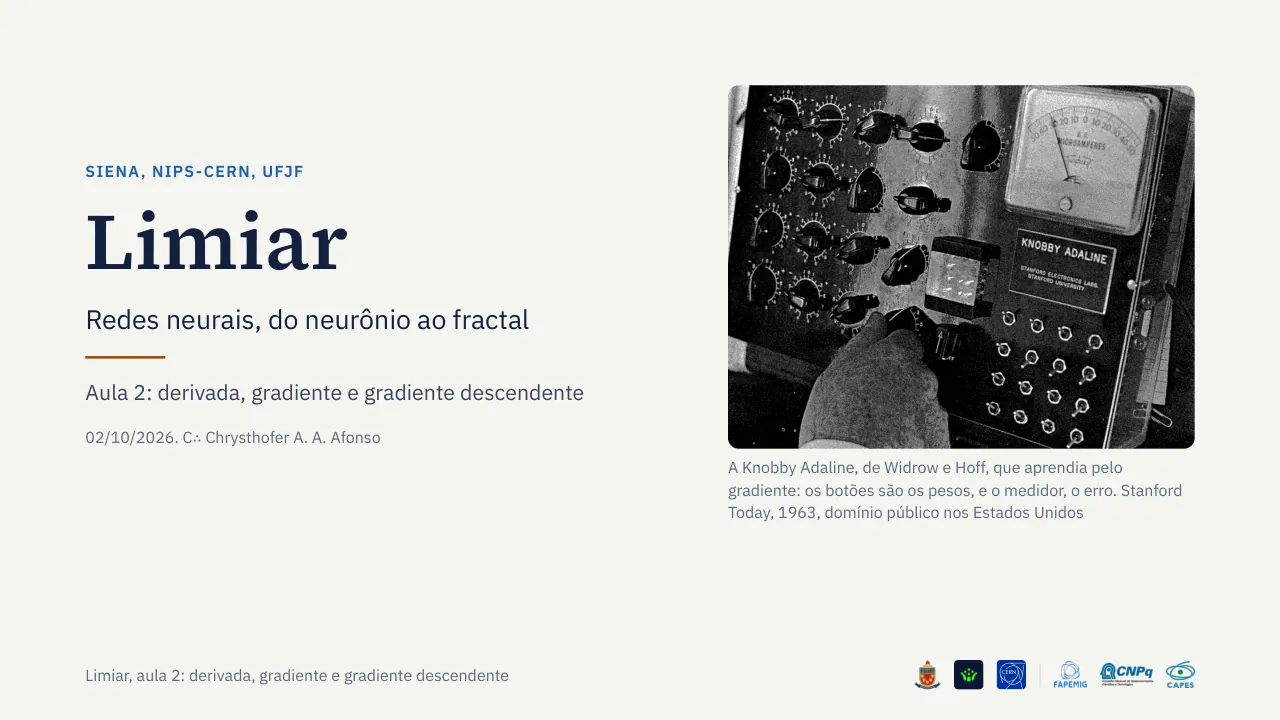
knobby-adaline.jpg a Knobby Adaline dos Stanford Electronics Labs, na capa; "Knobby ADALINE.jpg", reduzida Stanford Today, 1963 domínio público nos Estados Unidos, direito autoral não renovado
widrow-adaline.jpg Bernard Widrow com uma Adaline; "Bernard Widrow with ADALINE.jpg", reduzida Stanford Today, 1963 domínio público nos Estados Unidos, direito autoral não renovado
cauchy.jpg retrato de Augustin-Louis Cauchy, litografia, por volta de 1840; "Cauchy Augustin Louis dibner coll SIL14-C2-03a.jpg", coleção Dibner do Smithsonian, reduzido Louis Grégoire e Deneux domínio público

As fontes dos vídeos, IBM Plex Sans e Source Serif 4, as mesmas dos slides, estão em infra/fontes/, com as licenças, a SIL Open Font License.