SIENA, NIPS-CERN, UFJF
Limiar
Redes neurais, do neurônio ao fractal
Aula 2: derivada, gradiente e gradiente descendente
02/10/2026. C∴ Chrysthofer A. A. Afonso
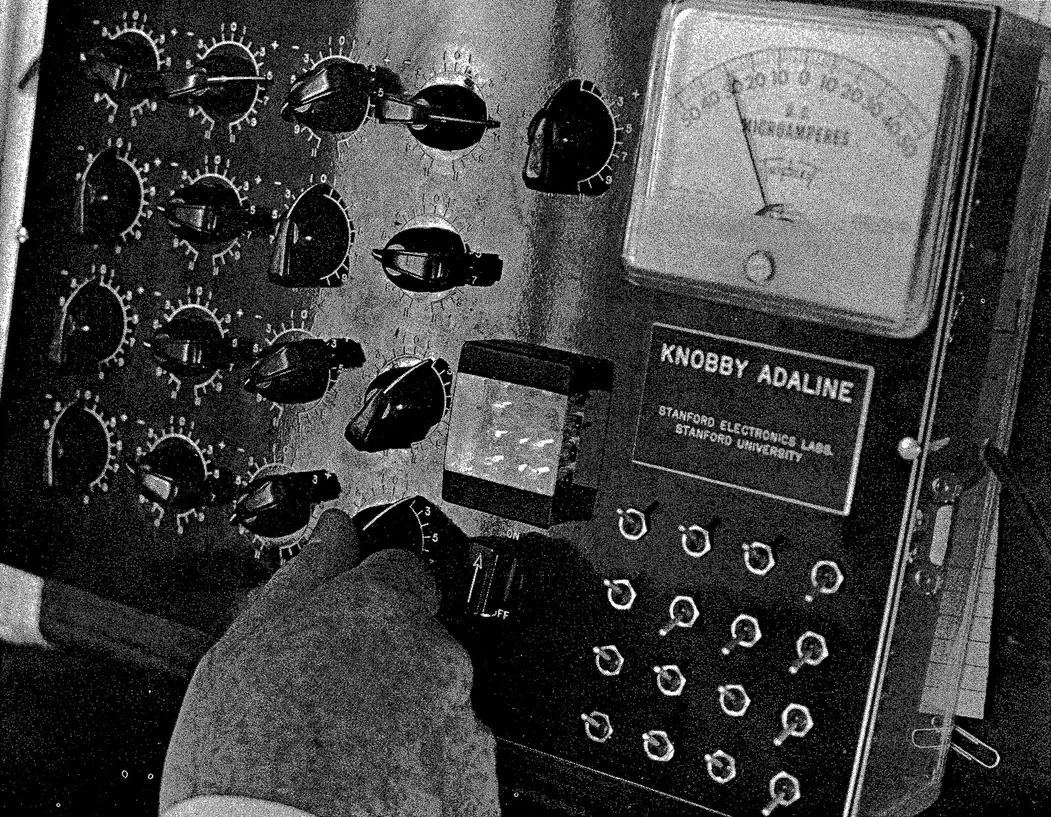
A Knobby Adaline, de Widrow e Hoff, que aprendia pelo gradiente: os botões são os pesos, e o medidor, o erro. Stanford Today, 1963, domínio público nos Estados Unidos
Limiar, aula 2: derivada, gradiente e gradiente descendente




1 · Revisão
O que ficou da aula 1, de memória
1
O que o neurônio calcula?
2
O que a regra faz quando erra?
3
Por que o treino do E termina?
4
E no XOR?
Limiar, aula 2: derivada, gradiente e gradiente descendente
1 · Revisão
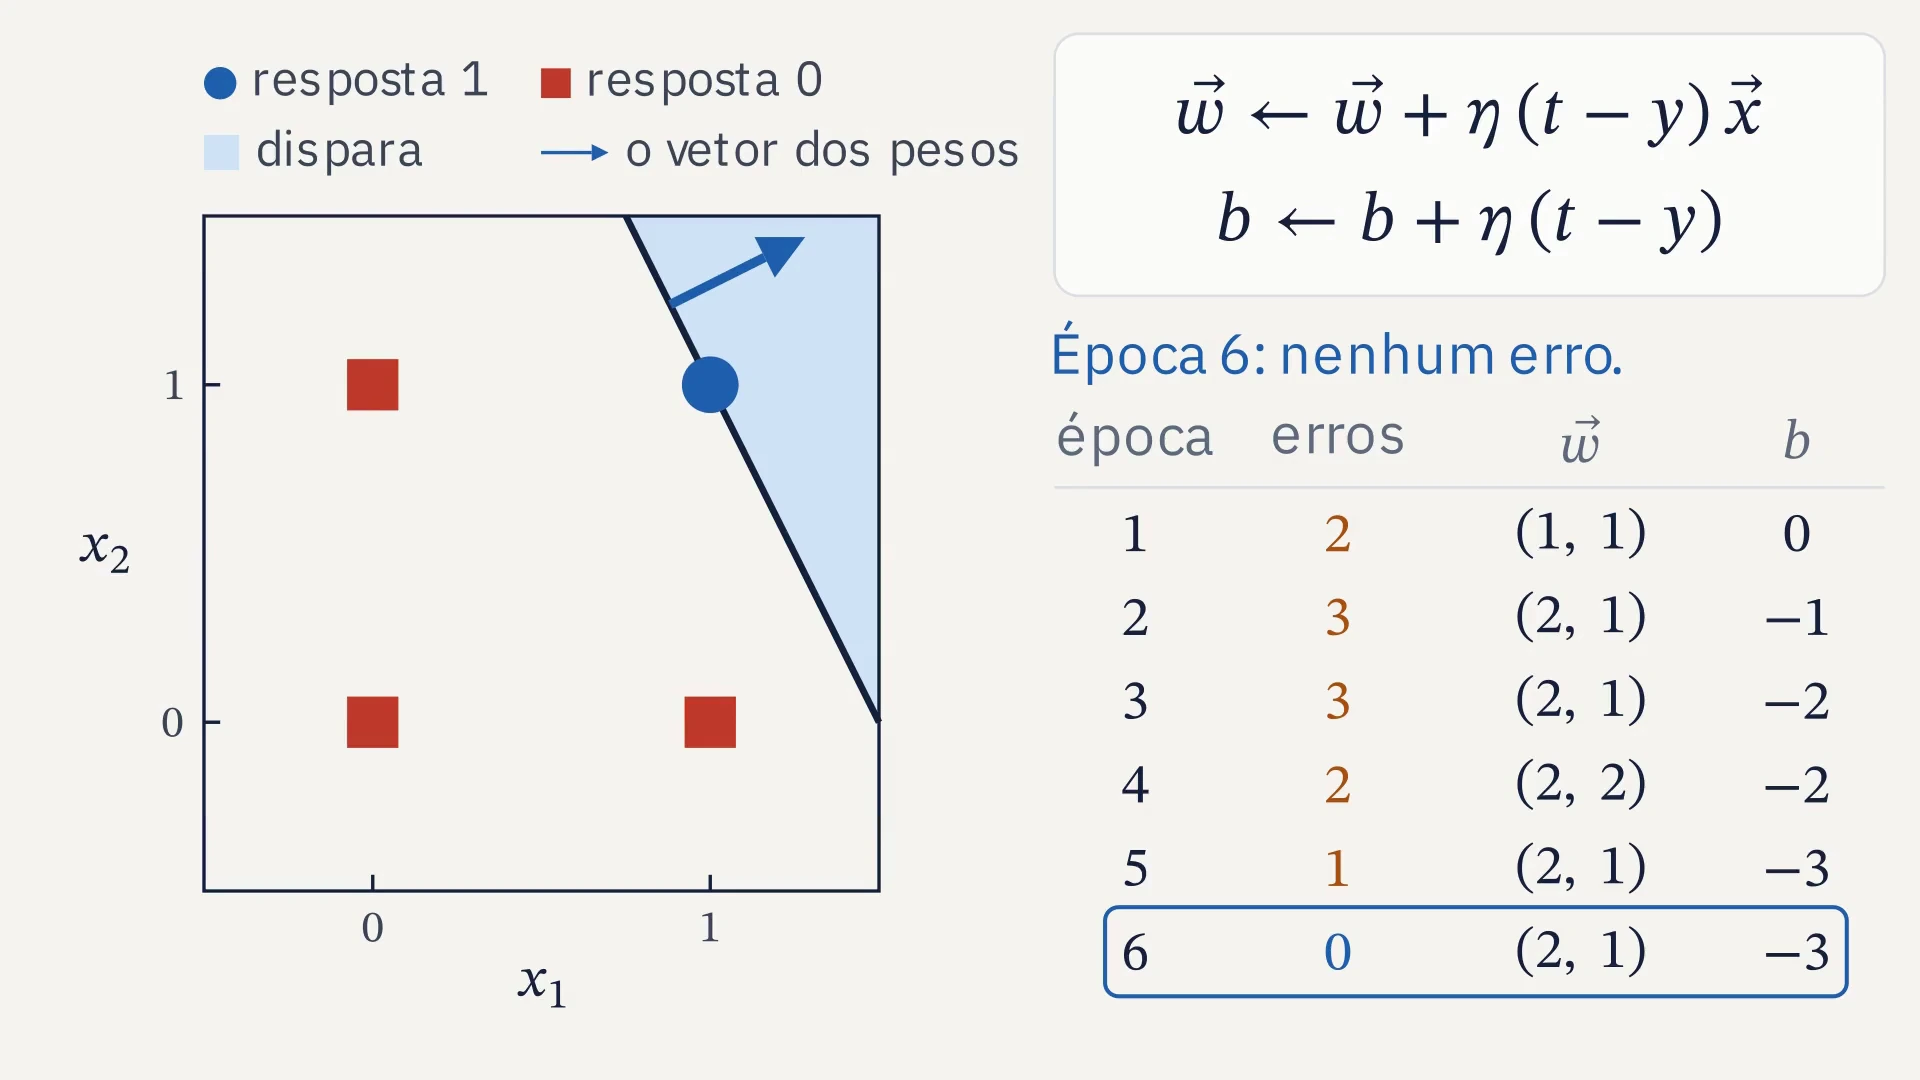
A regra do perceptron aprende o E
Limiar, aula 2: derivada, gradiente e gradiente descendente
1 · Revisão
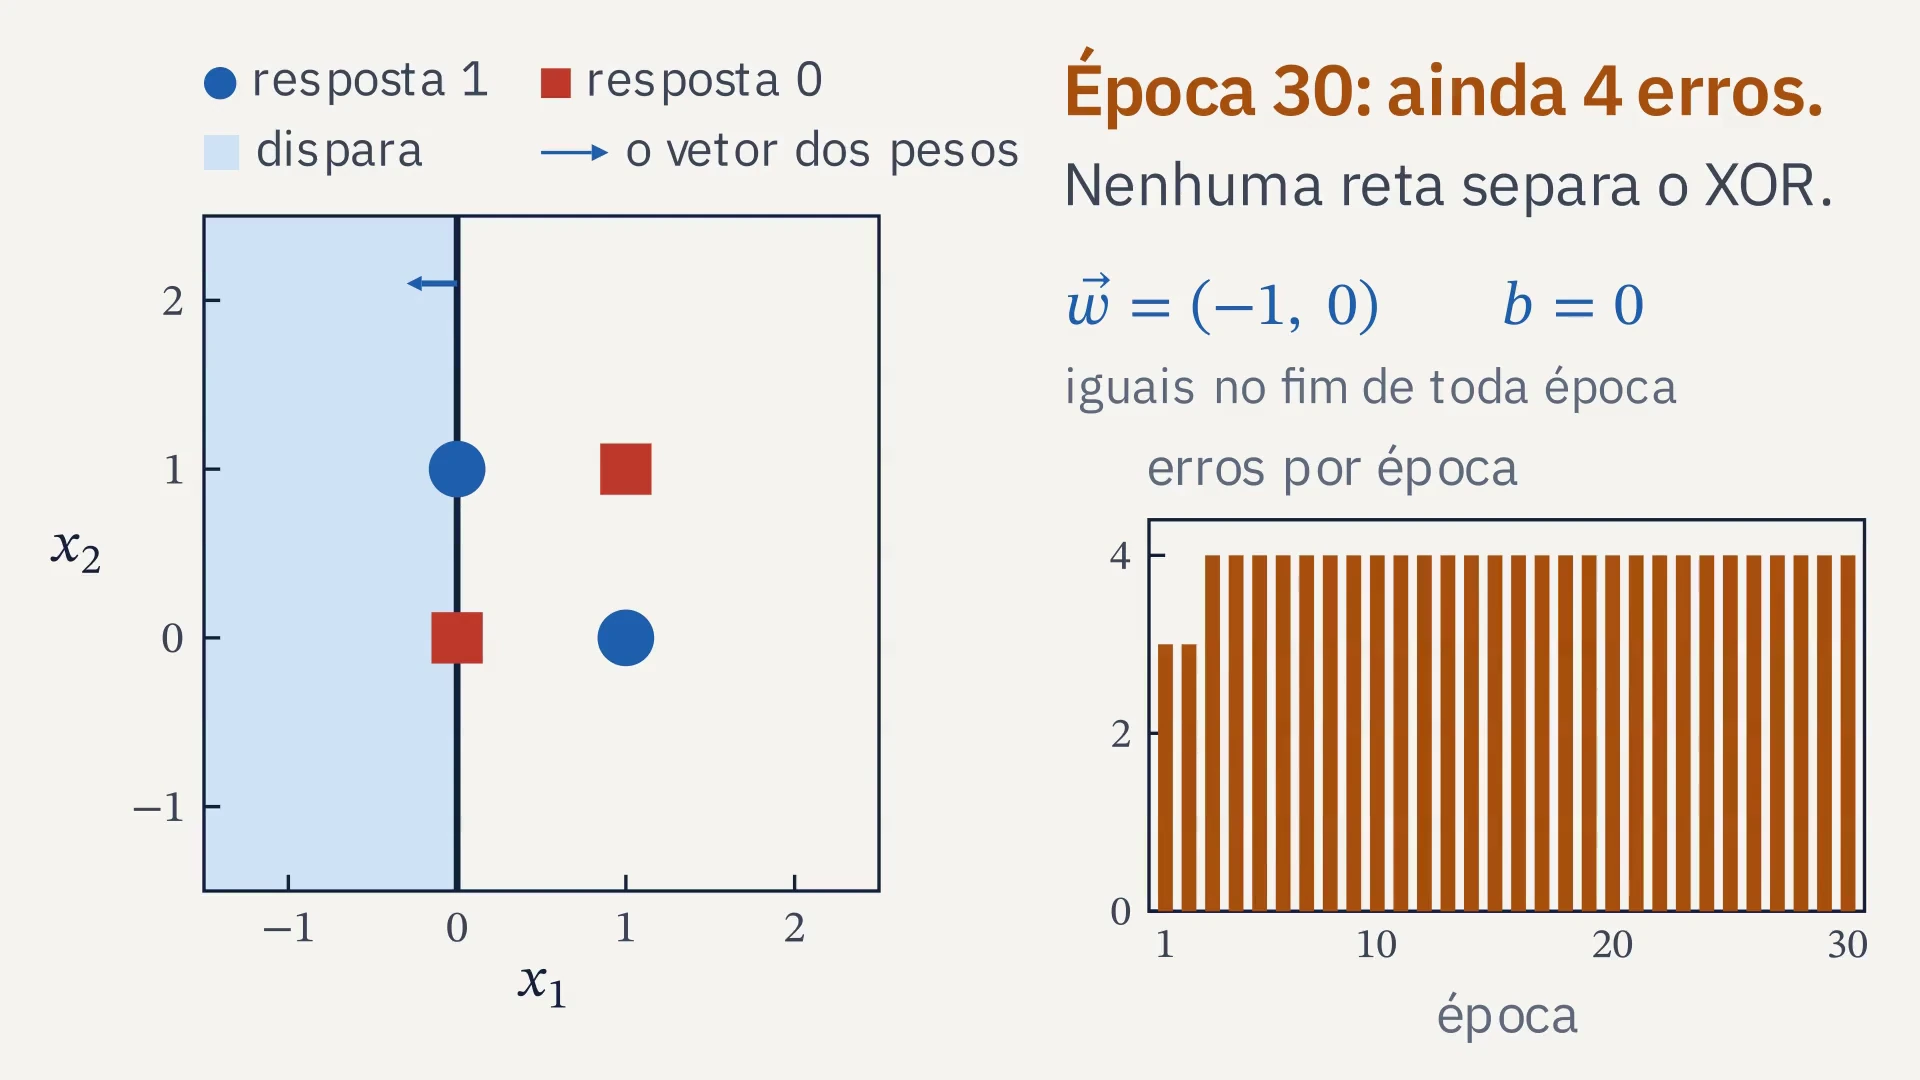
No XOR, a regra nunca para
Limiar, aula 2: derivada, gradiente e gradiente descendente
2 · Seminário
Os vídeos e o perceptron de E e OU
Os vídeos
- neurônio entre 0 e 1, contra 0 ou 1: o que muda?
- o que o vídeo chama de custo?
- por que a derivada num instante parece um paradoxo?
O código
- o perceptron de E e OU, linha a linha
- a tabela bate com a do slide das épocas?
- uma pergunta de cada um
Limiar, aula 2: derivada, gradiente e gradiente descendente
3 · O neurônio sem o degrau
O neurônio sem o degrau
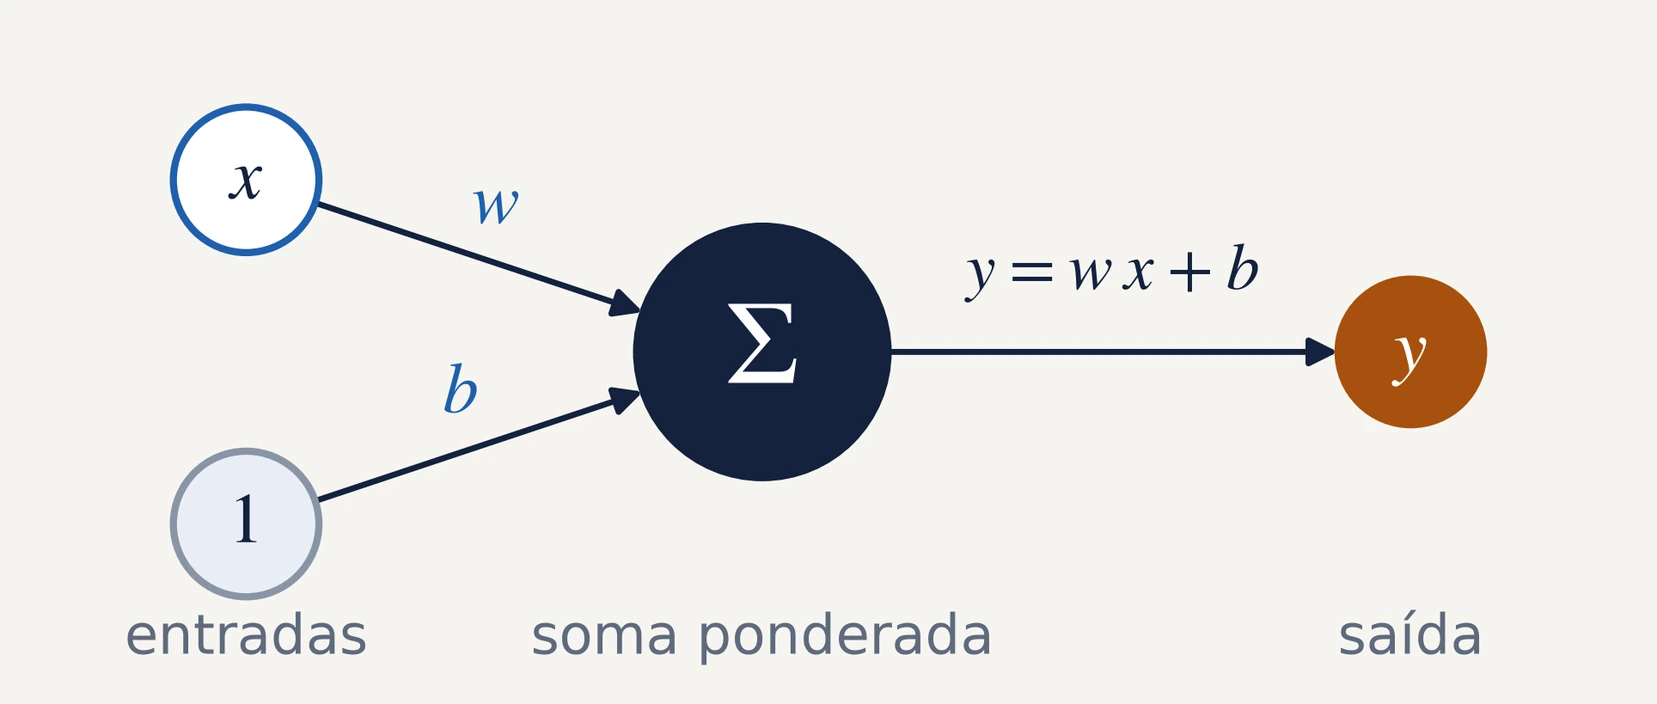
Com uma entrada, o neurônio é uma reta: w é a inclinação, e b, a altura em que ela corta o eixo.
Sem o degrau, o erro y − t tem tamanho: diz quanto e para que lado o neurônio errou.
Limiar, aula 2: derivada, gradiente e gradiente descendente
3 · O neurônio sem o degrau
O erro quadrático médio
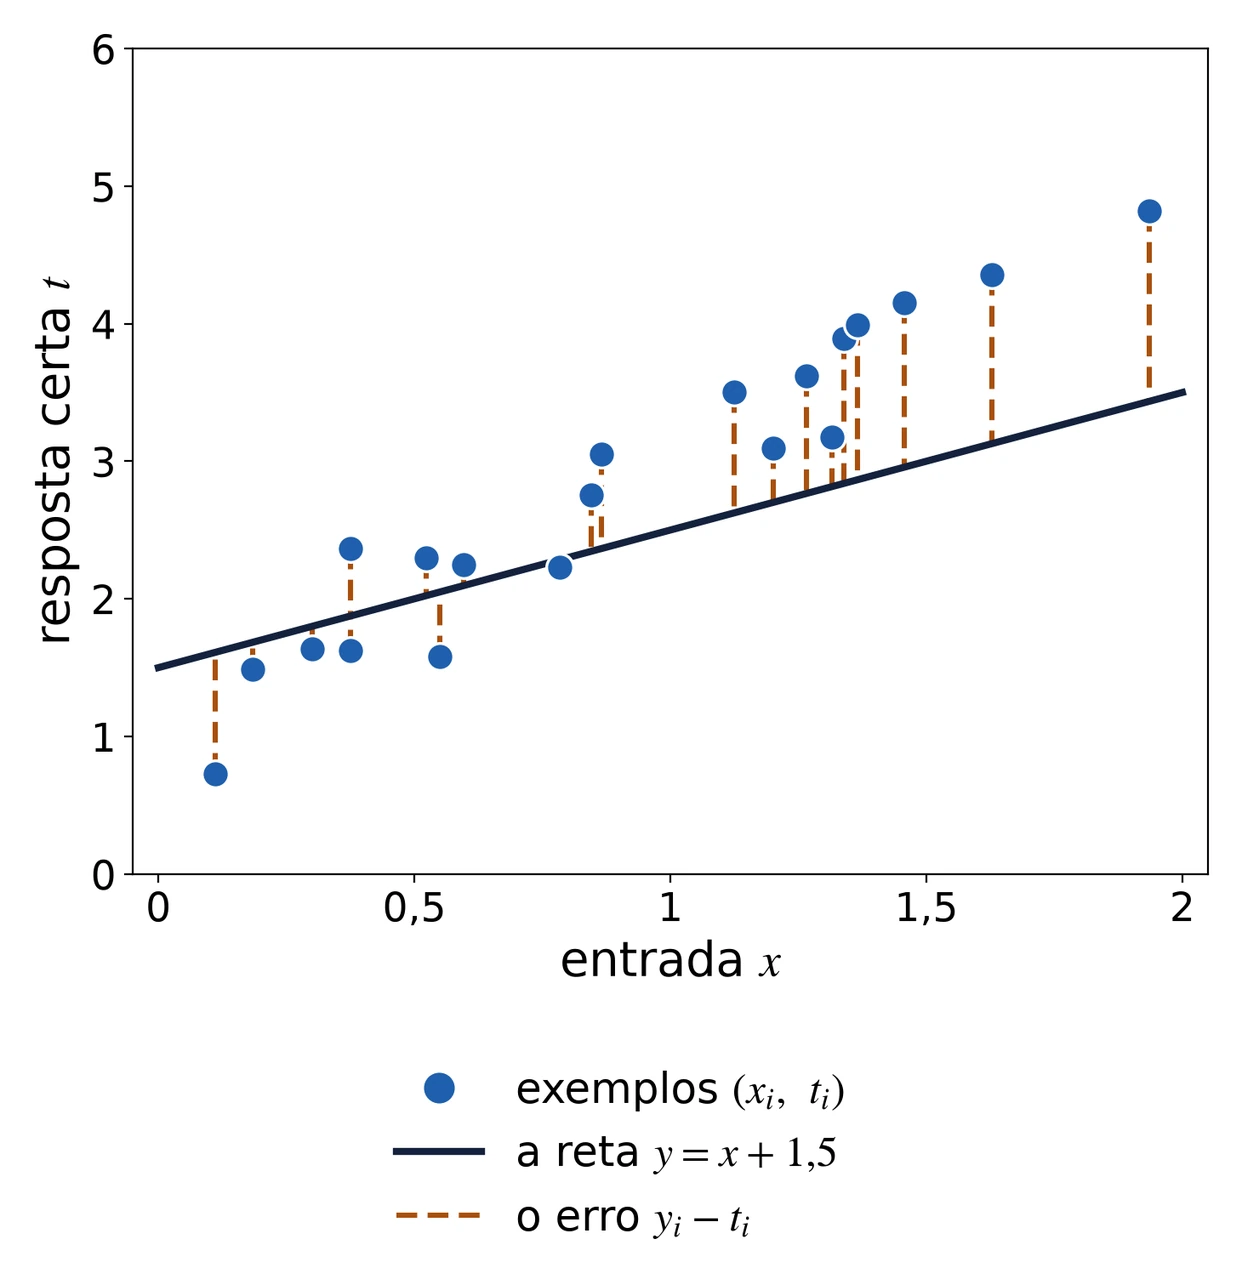
L de w e b é a média, de i igual a 1 até N, dos quadrados dos erros
A reta da figura, y = x + 1,5, tem L = 0,556. A melhor reta tem L = 0,087.
Limiar, aula 2: derivada, gradiente e gradiente descendente
3 · O neurônio sem o degrau
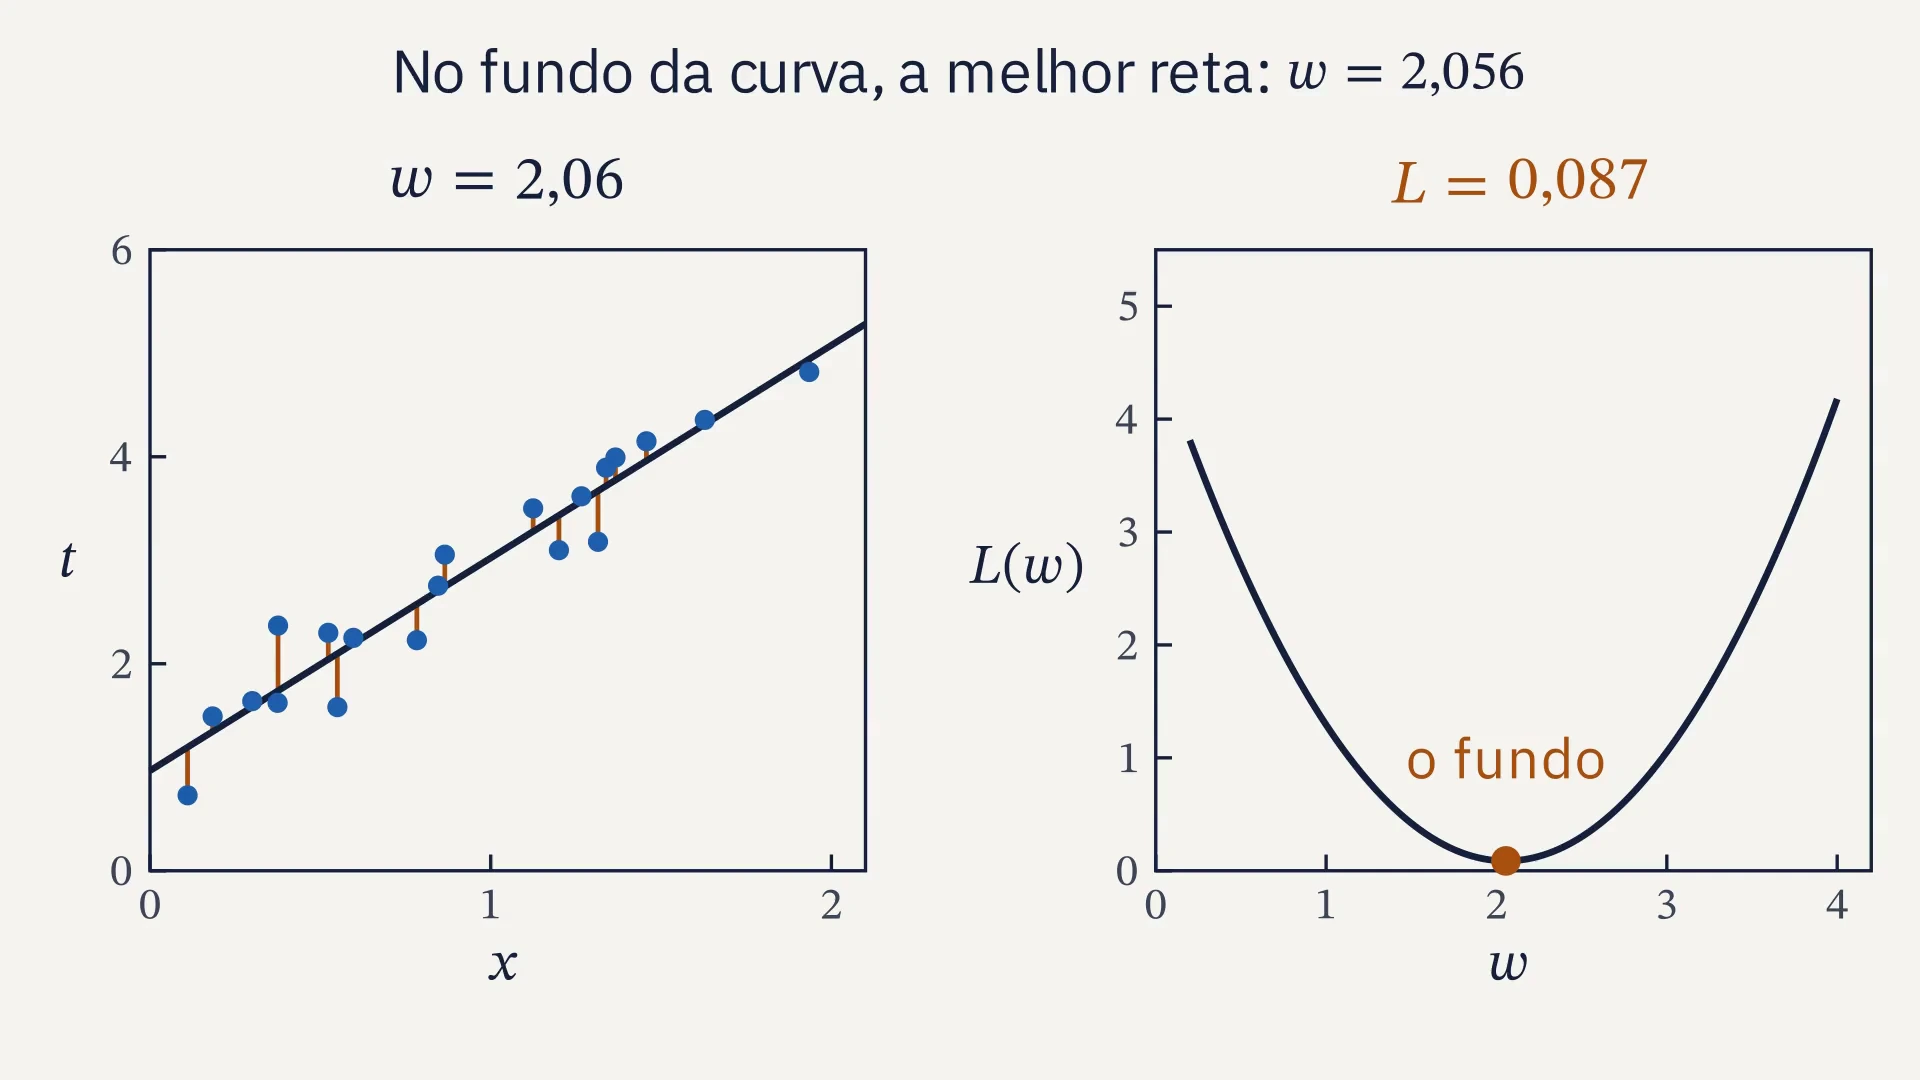
A perda depende do peso
Limiar, aula 2: derivada, gradiente e gradiente descendente
3 · O neurônio sem o degrau
Para que lado mexer w, e quanto, para a perda cair?
Limiar, aula 2: derivada, gradiente e gradiente descendente
4 · A derivada
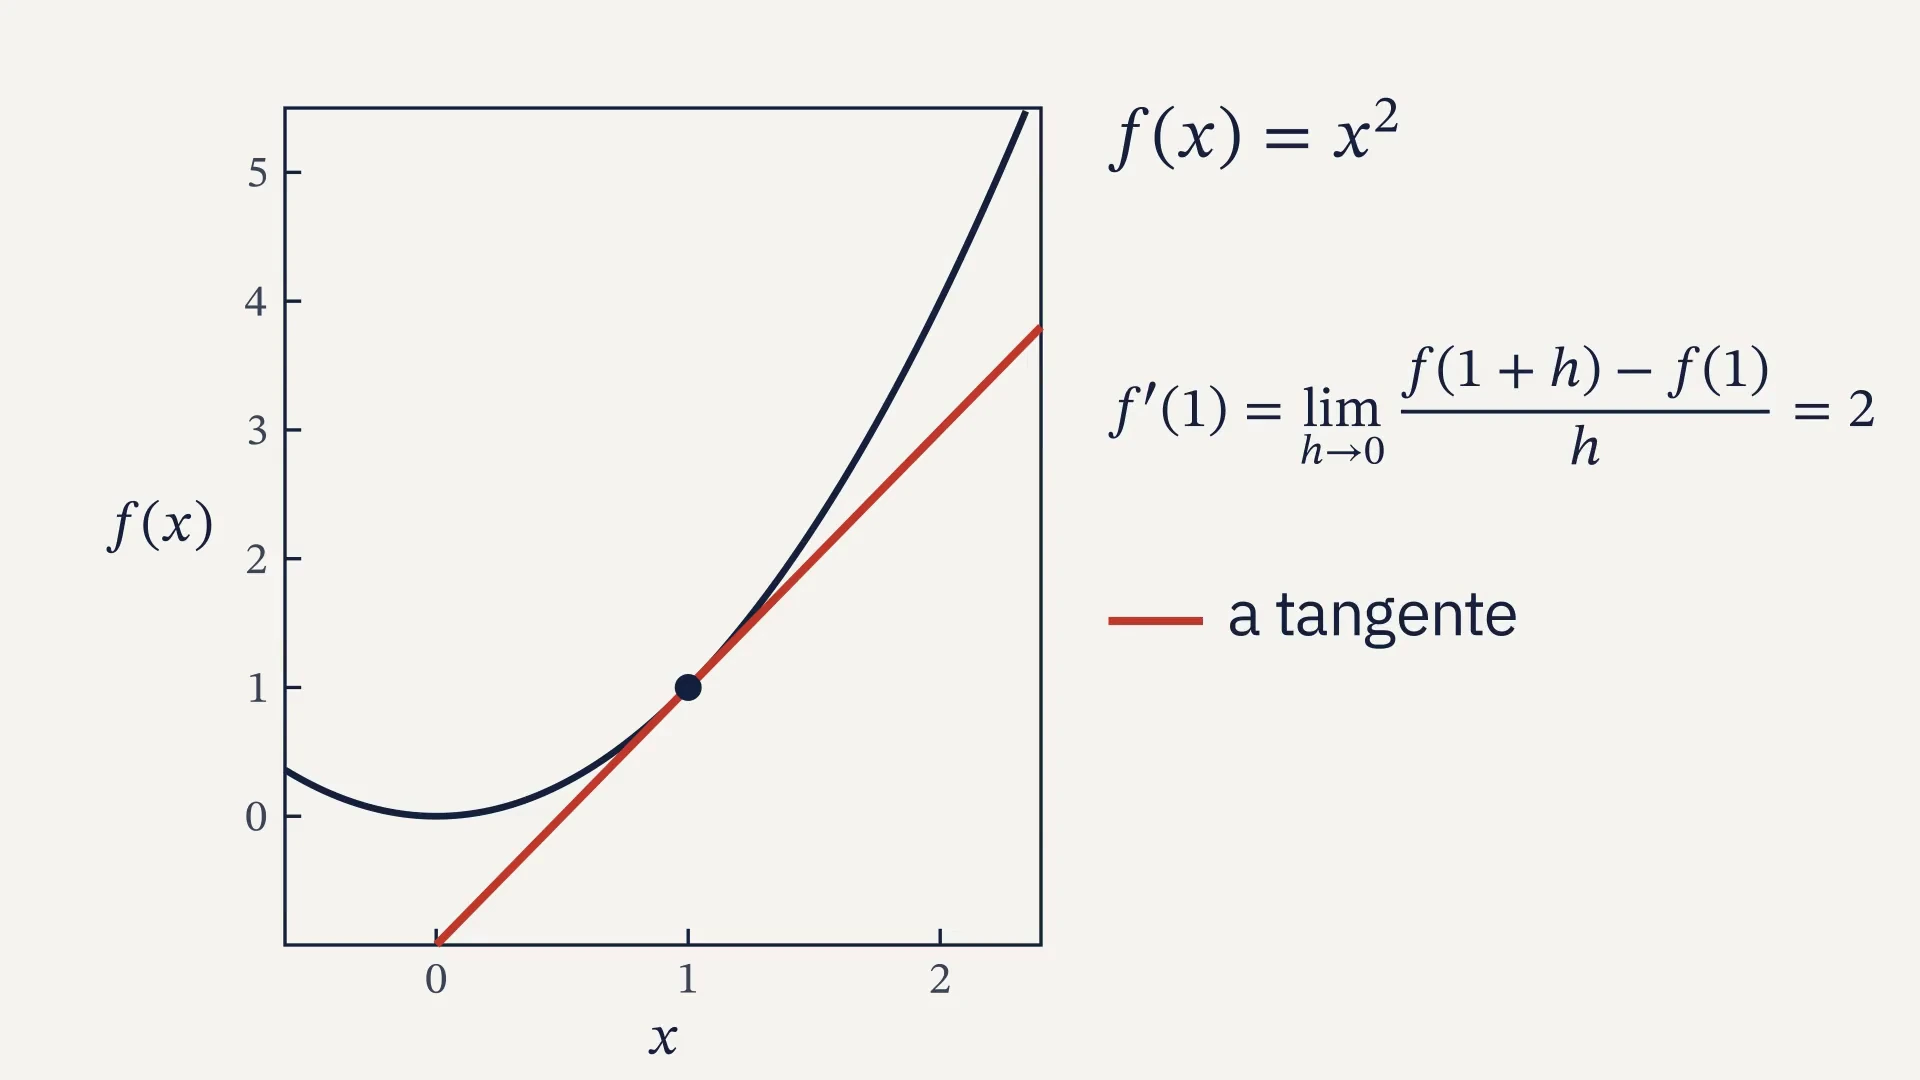
A derivada: quanto a saída muda
Limiar, aula 2: derivada, gradiente e gradiente descendente
4 · A derivada
A derivada de x² pela definição
Três regras que bastam
c é um número fixo; f e g, duas funções
1
3
0,5
2,5
0,1
2,1
0,01
2,01
Em x = 1, a razão vale 2 + h: a derivada numérica.
Limiar, aula 2: derivada, gradiente e gradiente descendente
4 · A derivada
A derivada diz para onde descer
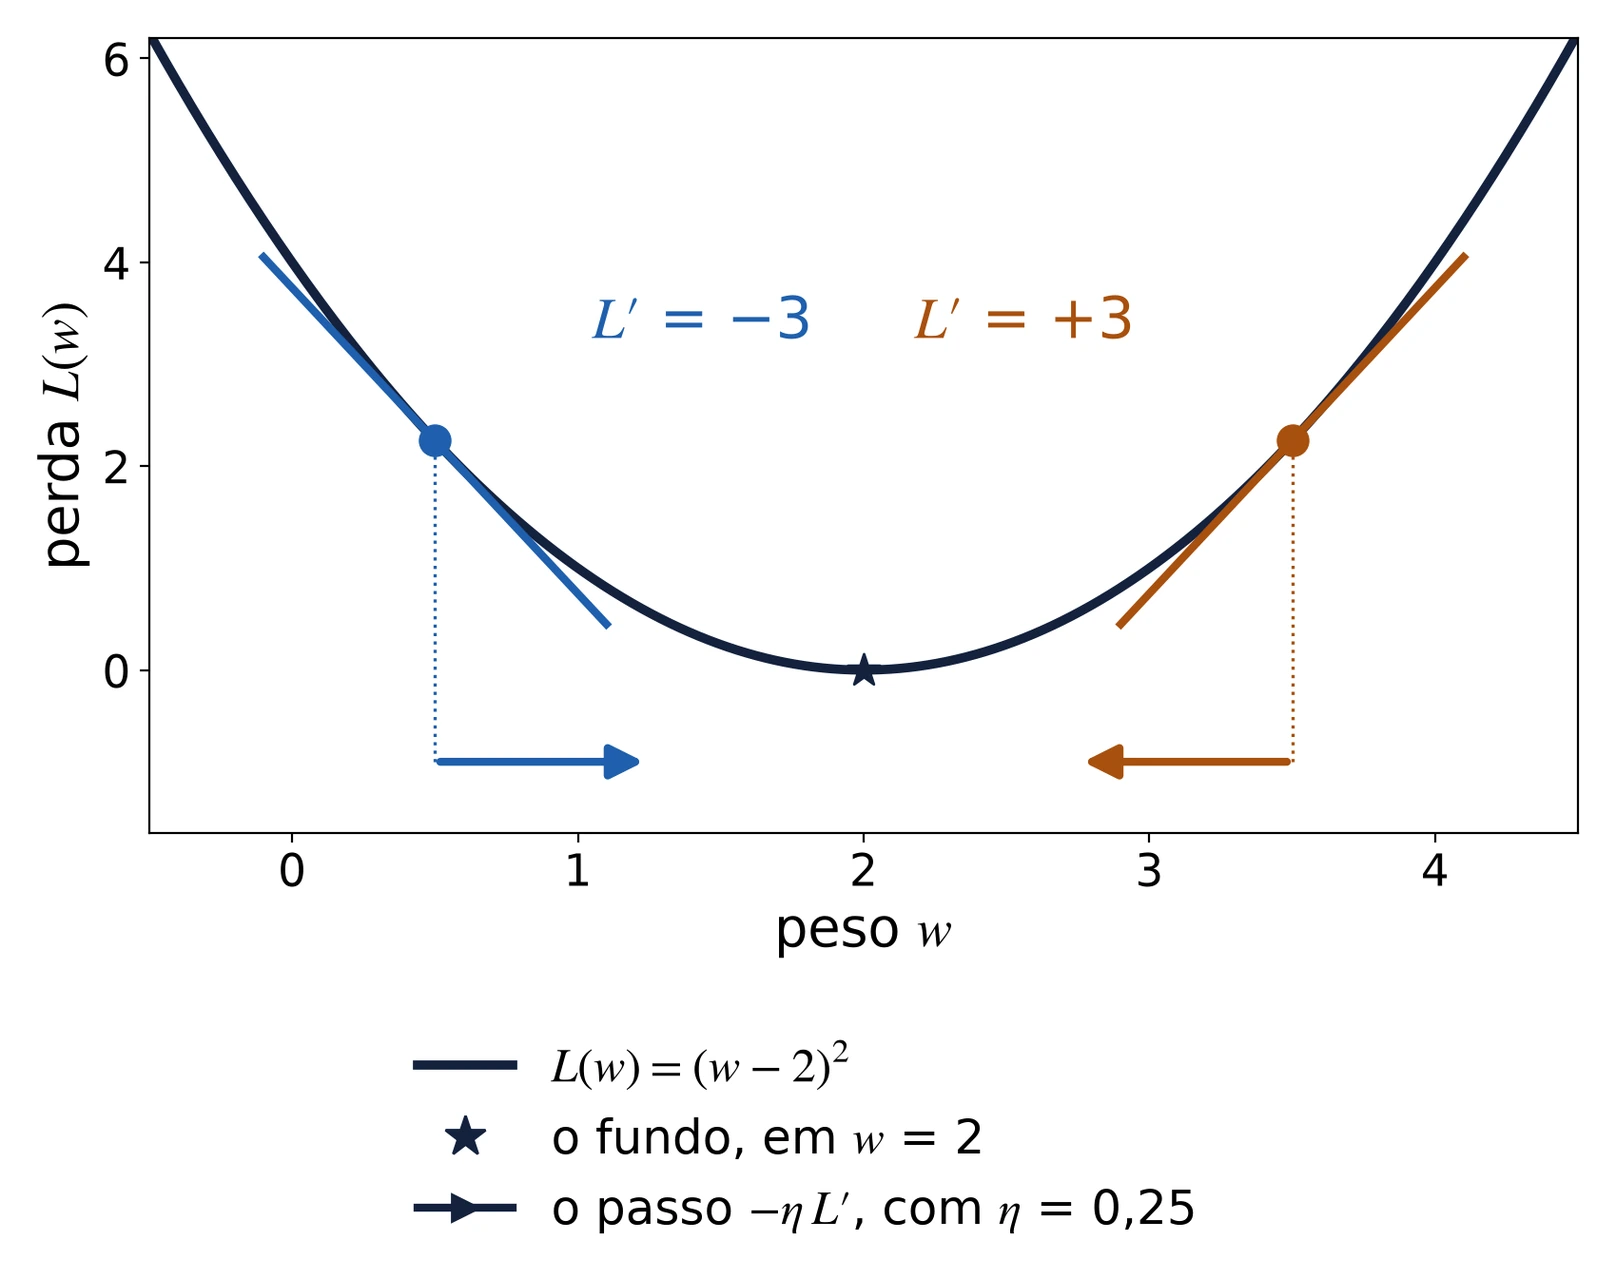
L′ < 0: a perda cai para a direita, e w aumenta.
L′ > 0: a perda cai para a esquerda, e w diminui.
Longe do fundo, a inclinação é grande, e o passo também; perto, os passos encolhem sozinhos.
Limiar, aula 2: derivada, gradiente e gradiente descendente
5 · Derivada parcial e gradiente
Derivada parcial: um corte na superfície
Limiar, aula 2: derivada, gradiente e gradiente descendente
5 · Derivada parcial e gradiente
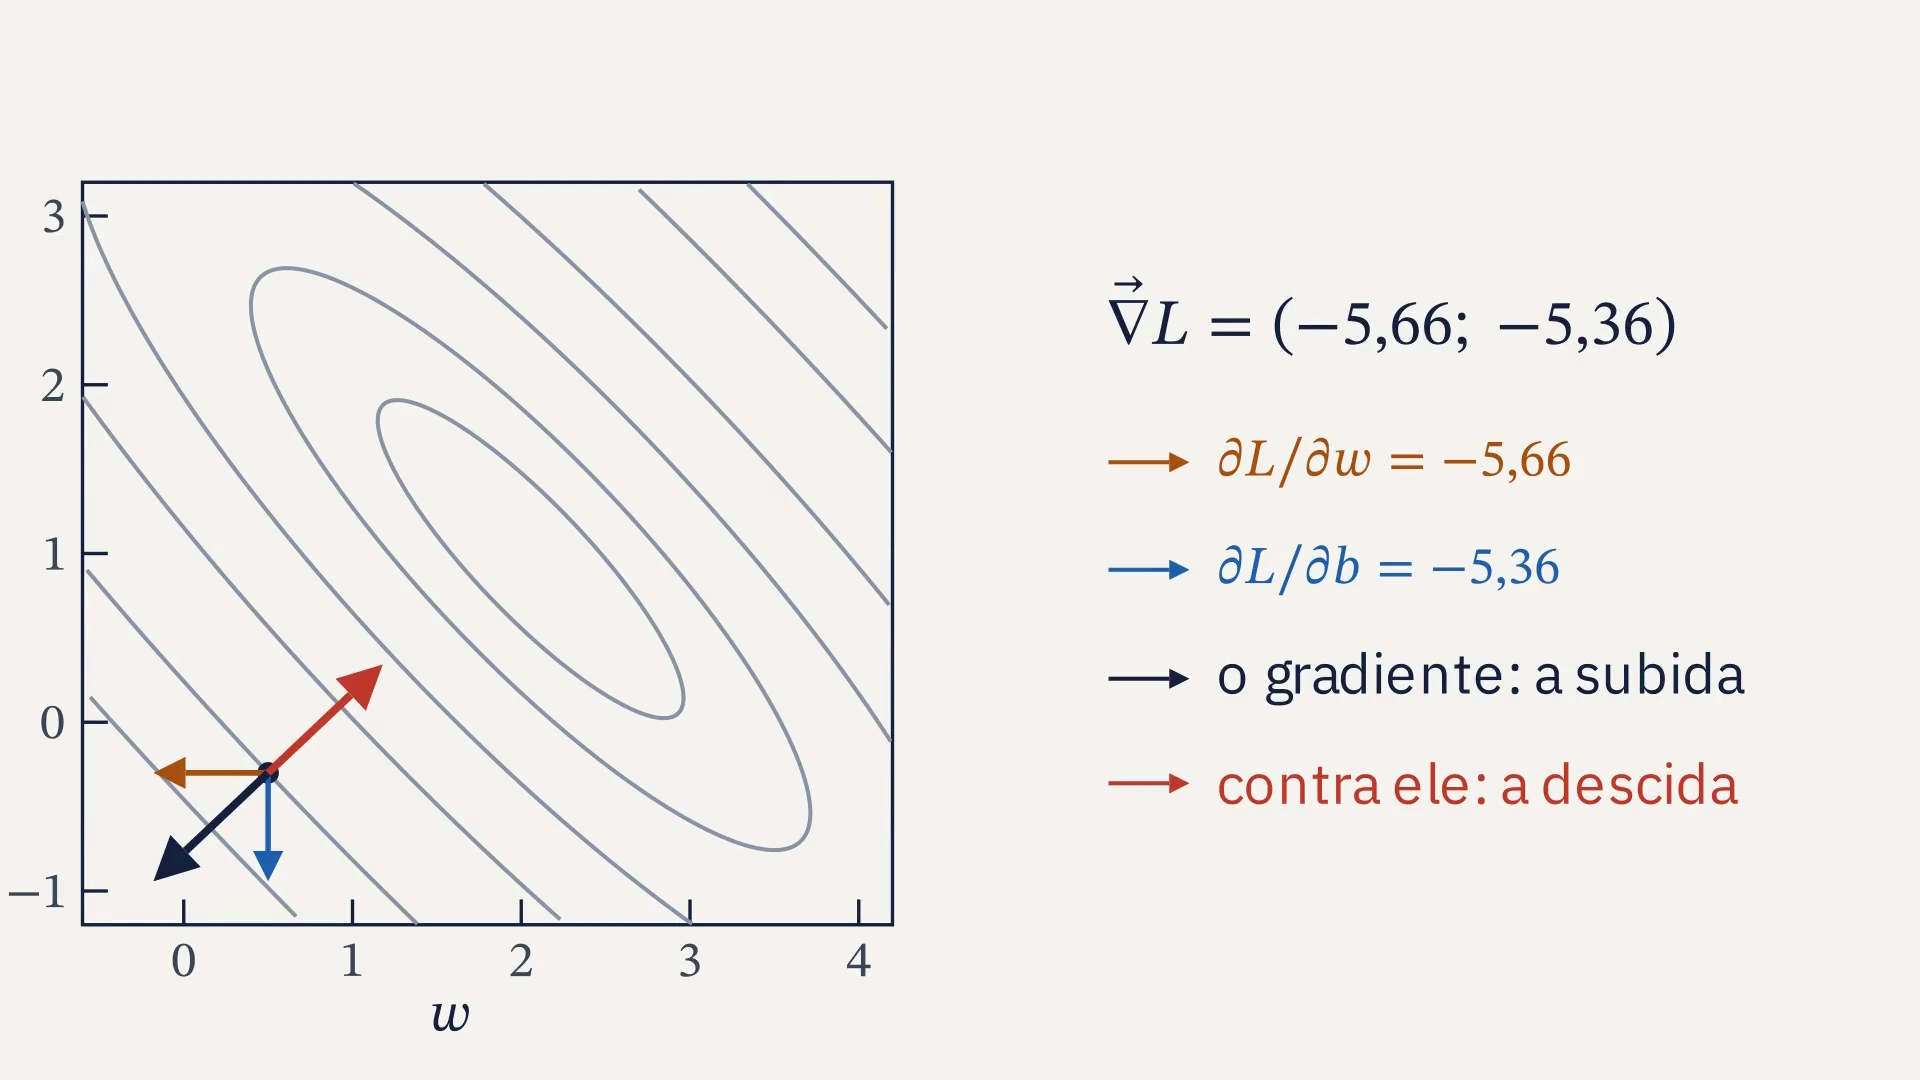
As duas derivadas parciais da perda
derivada parcial de L em relação a w: só w varia, e b fica parado
De onde vem
é uma parábola em w; derivando em w, sai 2(yᵢ − tᵢ) xᵢ
Conferido
em (0,5; −0,3), a fórmula e a derivada numérica dão (−5,6643; −5,3552)
Limiar, aula 2: derivada, gradiente e gradiente descendente
5 · Derivada parcial e gradiente
O gradiente
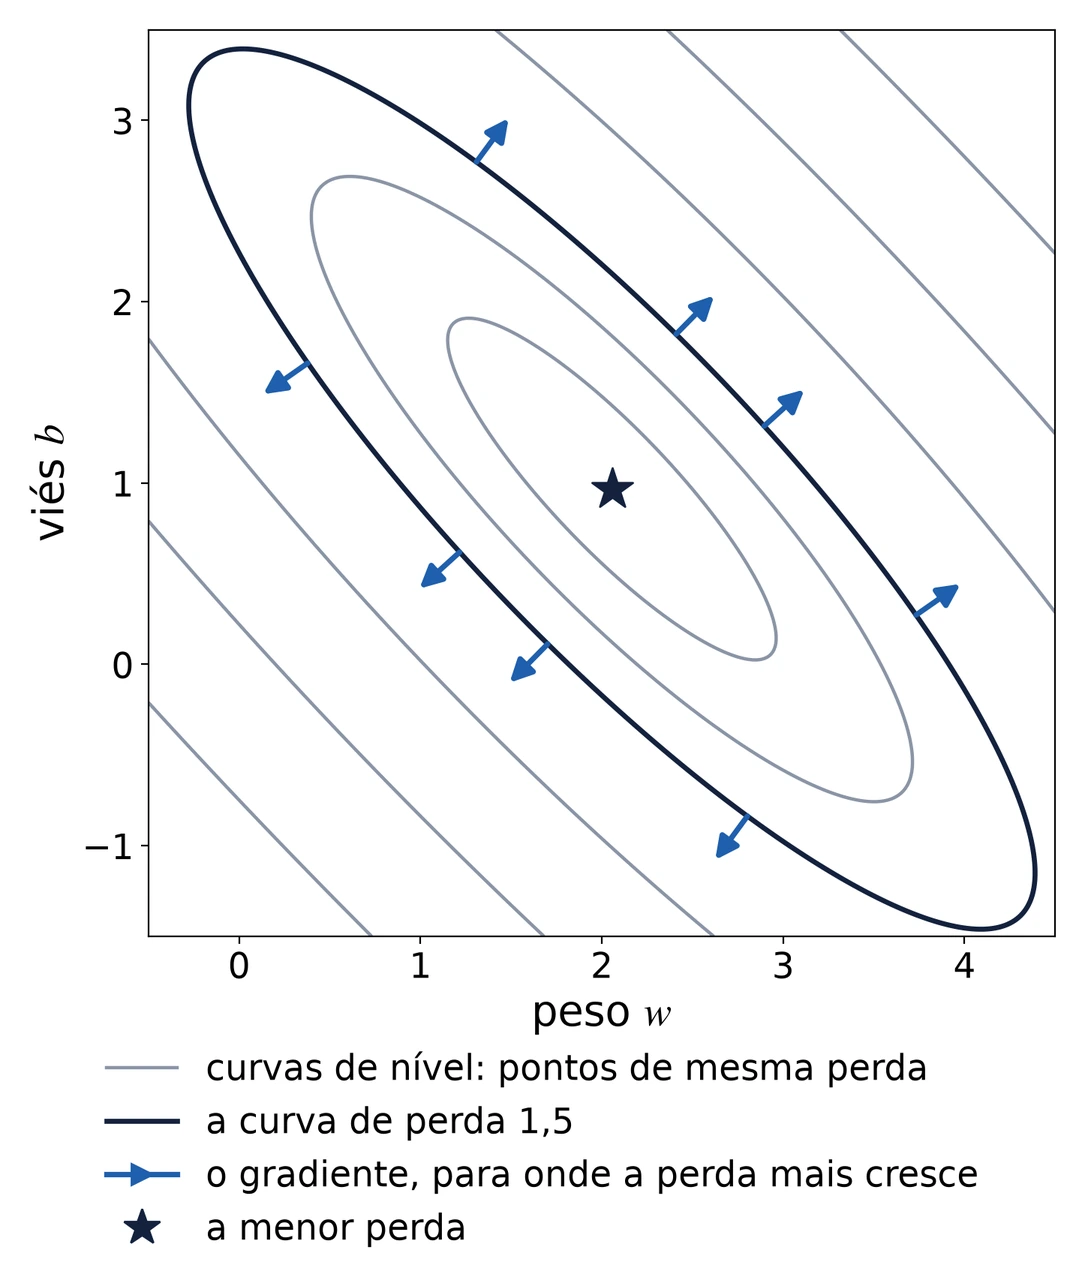
nabla L, o gradiente: o vetor das derivadas parciais
Aponta para onde a perda mais cresce. Descer mais depressa é andar contra ele.
De onde vem o nome: gradiente
do latim gradiens, que anda, de gradior, dar passos, de gradus, passo; a mesma raiz de degrau, a função da aula 1.
Limiar, aula 2: derivada, gradiente e gradiente descendente
6 · Gradiente descendente
Gradiente descendente
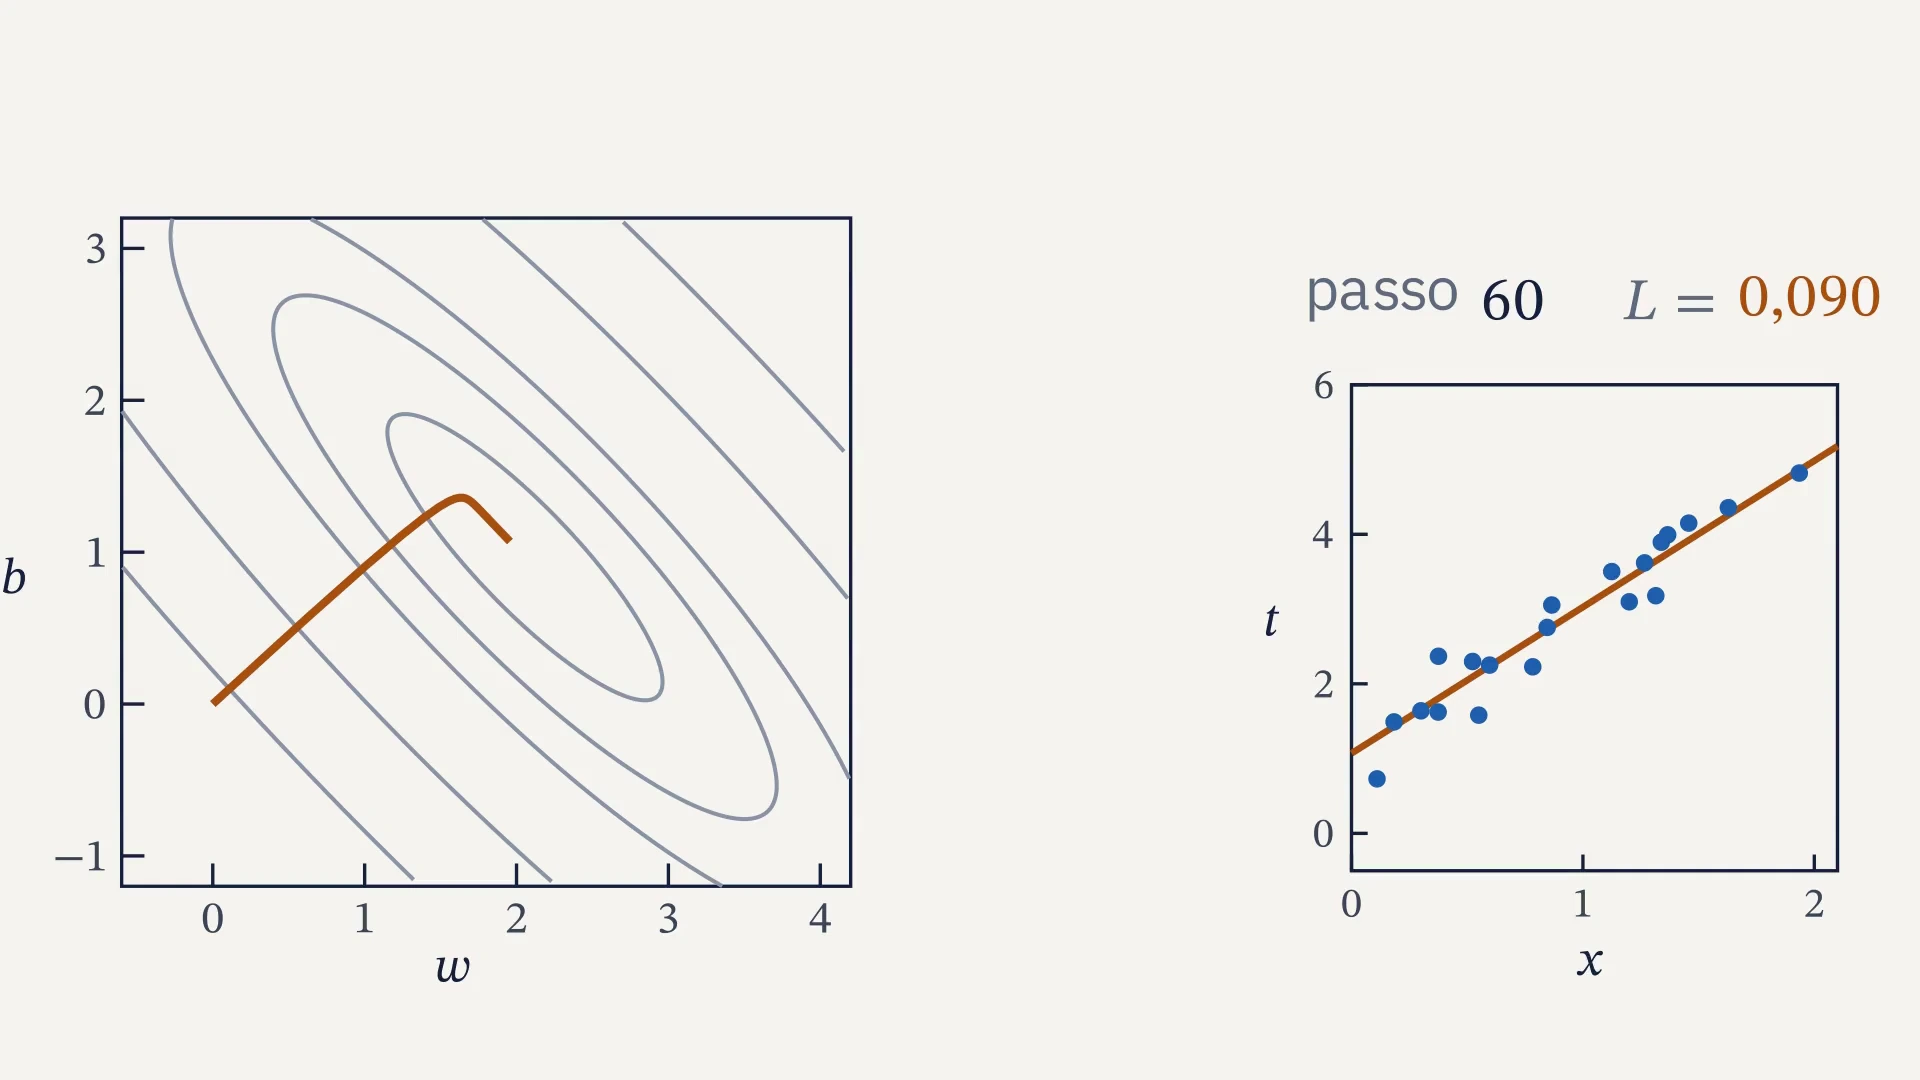
Limiar, aula 2: derivada, gradiente e gradiente descendente
6 · Gradiente descendente
A taxa de aprendizado
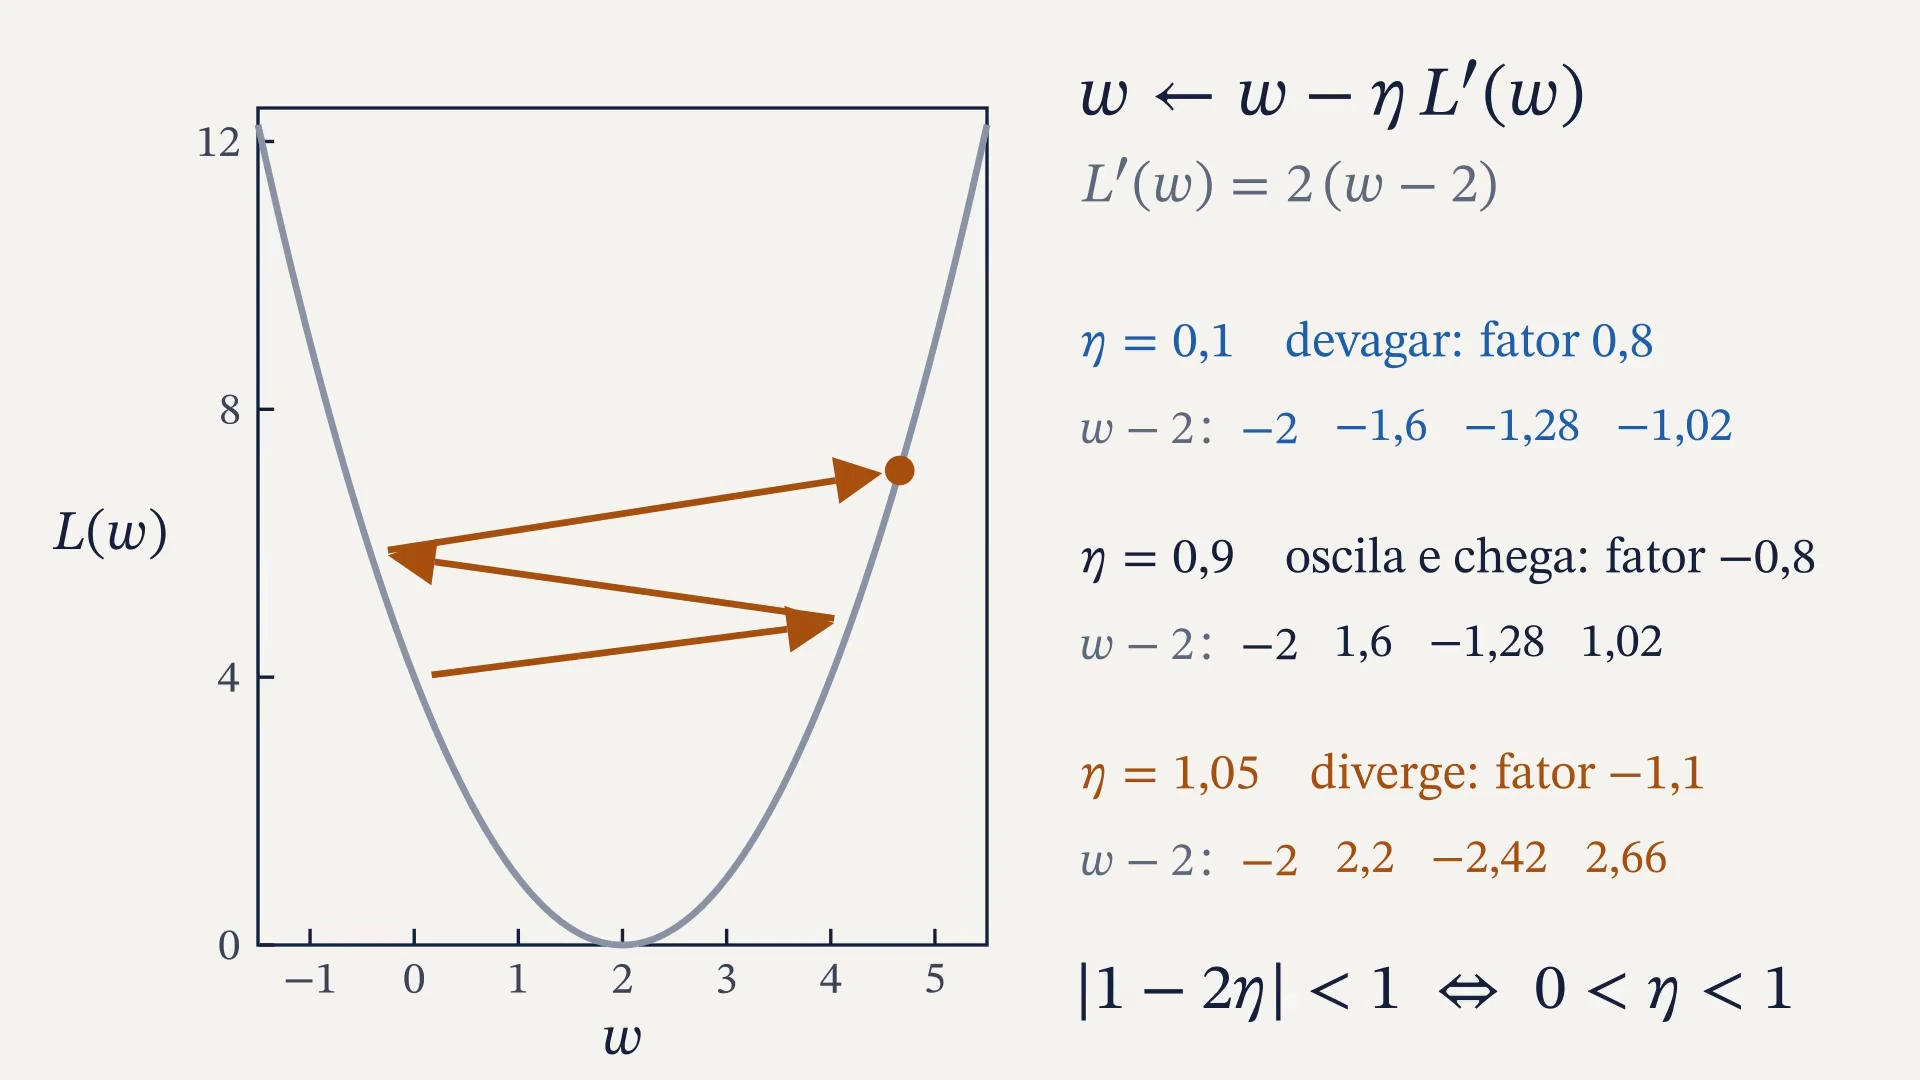
Limiar, aula 2: derivada, gradiente e gradiente descendente
6 · Gradiente descendente
Um limiar de novo

Com a reta, o treino converge até η ≈ 0,513 e explode acima. No projeto de dezembro, uma taxa por camada, e a fronteira vira uma curva: no artigo de Sohl-Dickstein, fractal.
Limiar, aula 2: derivada, gradiente e gradiente descendente
7 · De onde vem
1847: Cauchy e as órbitas
“Para achar os valores de x, y, z, … que satisfazem a equação u = 0, basta fazer a função u decrescer indefinidamente, até que ela se anule.”
Augustin-Louis Cauchy, Comptes rendus da Academia de Ciências de Paris, 18 de outubro de 1847, tradução livre
- o problema: a órbita de um astro, com seis incógnitas
- o passo: cada variável anda contra a própria derivada parcial
- o tamanho do passo, pequeno o bastante: a taxa de aprendizado
θ, teta, é o passo; X, a derivada parcial em x
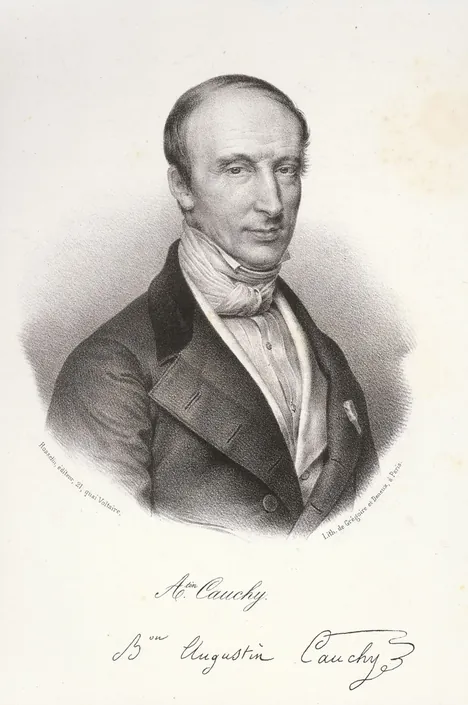
Augustin-Louis Cauchy, 1789 a 1857. Louis Grégoire e Deneux, por volta de 1840, domínio público
Limiar, aula 2: derivada, gradiente e gradiente descendente
7 · De onde vem
1960: a Adaline de Widrow e Hoff
- Adaline, de adaptive linear: um neurônio linear em circuito
- 16 chaves de entrada, 17 pesos em botões e um medidor do erro
- do tamanho de uma lancheira, nas palavras dos autores
A regra, um exemplo por vez
a do perceptron com z, a soma antes do degrau, no lugar de y
Virou o algoritmo LMS e o começo dos filtros adaptativos: aqui, caixa-preta, só a história.
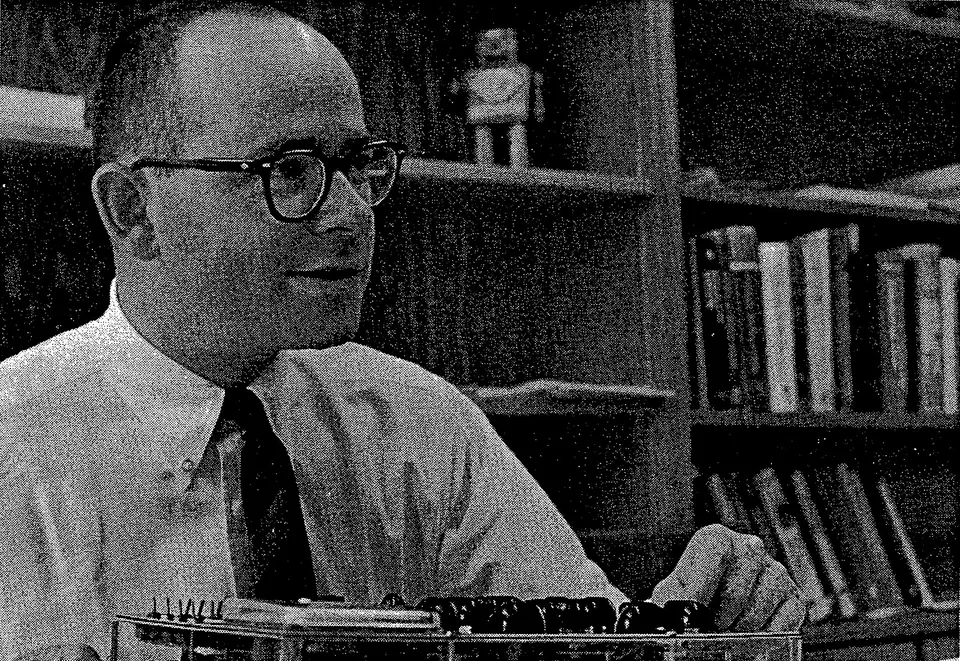
Bernard Widrow com uma Adaline. Stanford Today, 1963, domínio público nos Estados Unidos
Limiar, aula 2: derivada, gradiente e gradiente descendente
8 · O código
No laptop: a reta por gradiente descendente
1
Sortear 20 pontos em volta de t = 2x + 1, com a semente fixa
2
Escrever a perda, o erro quadrático médio
3
Escrever as duas derivadas parciais e conferir com a derivada numérica
4
O laço: 100 passos, guardando a perda de cada um
5
Treinar com várias taxas e achar a que diverge
O NumPy que resolve
rng = np.random.default_rng(2)
x = rng.uniform(0, 2, 20)
y = w * x + b
np.mean((y - t) ** 2)
com arrays, a conta vale para os 20 pontos de uma vez, sem laço
Limiar, aula 2: derivada, gradiente e gradiente descendente
8 · O código
O que a entrega pede
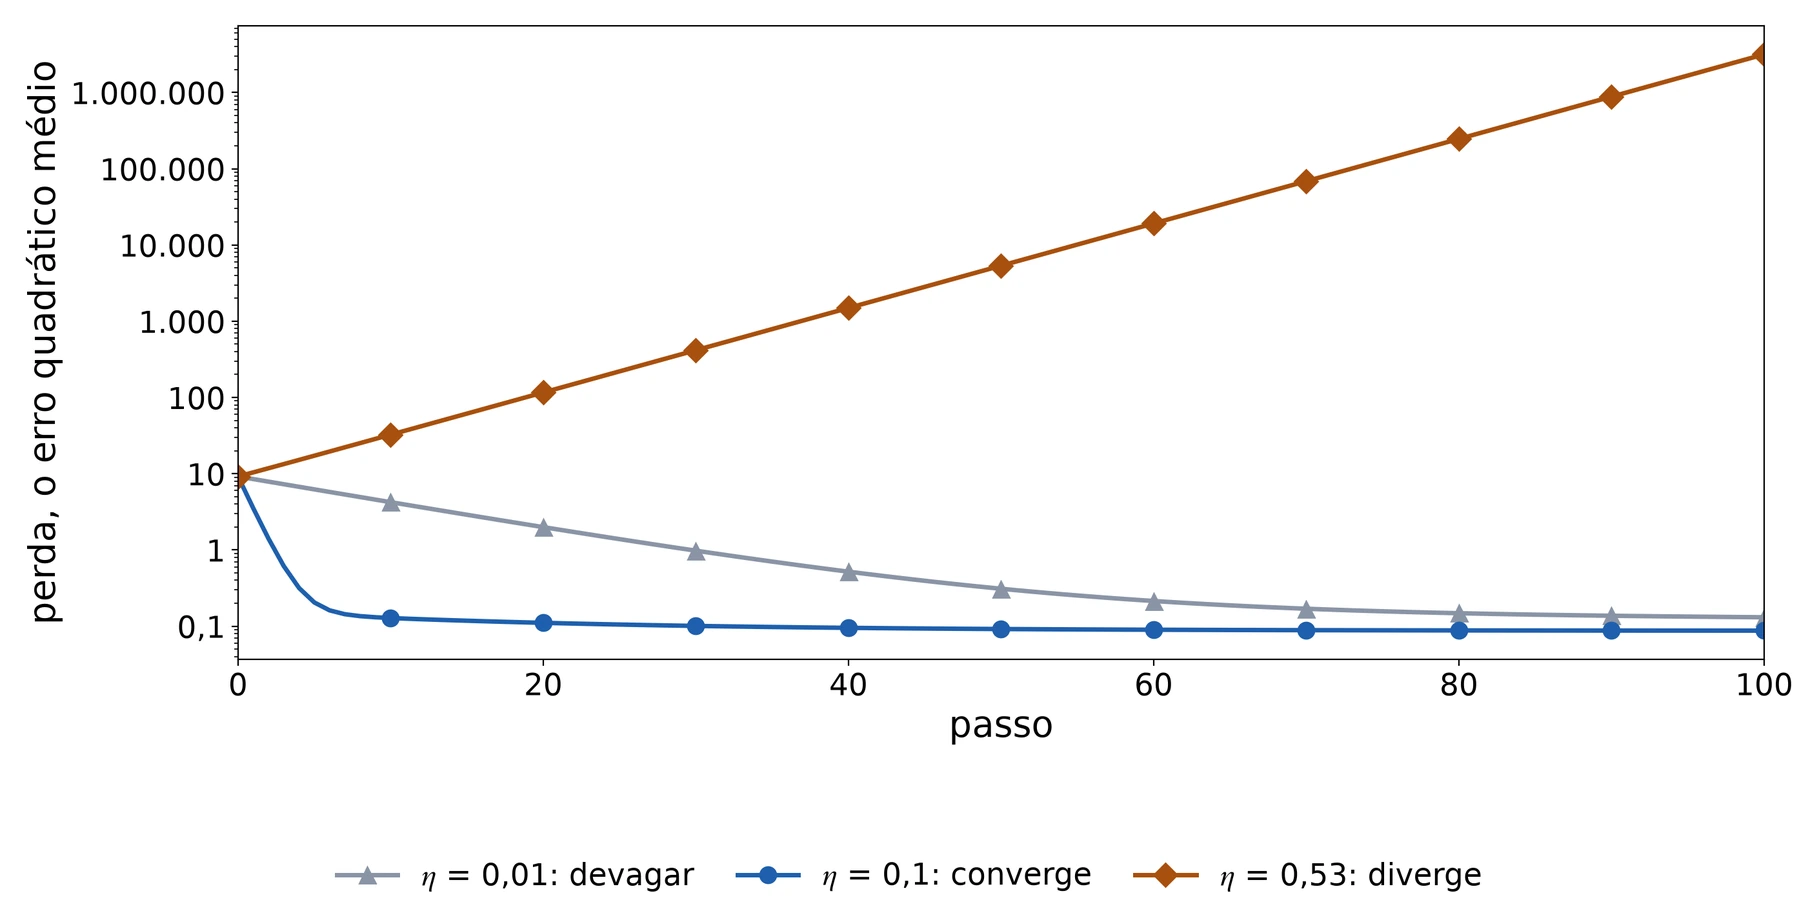
A perda a cada passo, uma curva por taxa, e a taxa a partir da qual o treino diverge. Cada um com os próprios pontos: o limiar muda com eles.
python aulas/02-gradiente/codigo/reta.py
Limiar, aula 2: derivada, gradiente e gradiente descendente
9 · Fechamento
Até 16/10: duas semanas, sem aula em 09/10
Estudo, até 16/10
- 3Blue1Brown, álgebra linear, capítulo 3
- 3Blue1Brown, álgebra linear, capítulo 4
- Nielsen, capítulo 1, até a arquitetura das redes
Entrega até 16/10
- a perda a cada passo, para várias taxas
- a taxa a partir da qual o treino diverge
- uma pergunta sobre o estudo
Seminário da aula 3
- o código da entrega, linha a linha
- o que é uma transformação linear?
- por que uma matriz guarda uma transformação?
- multiplicar matrizes: uma depois da outra
Limiar, aula 2: derivada, gradiente e gradiente descendente